浙江大学CAD&CG全国重点实验室沈春华教授团队关于机器人状态表征与运动学习的研究论文 “StaMo: Unsupervised Learning of Generalizable Robot Motion from Compact State Representation” 被 CVPR 2026 接收,并入选 Highlight。该工作重新审视具身智能中的一个基础问题:用于世界建模与决策的机器人状态表征,究竟应该“多重”才合适?能否仅从单张静态图像学到一个既足够紧凑、又足够富有表达力的状态表征,使得“运动”无需依赖复杂的时序视频建模,便能从两个状态之间自然地浮现出来?
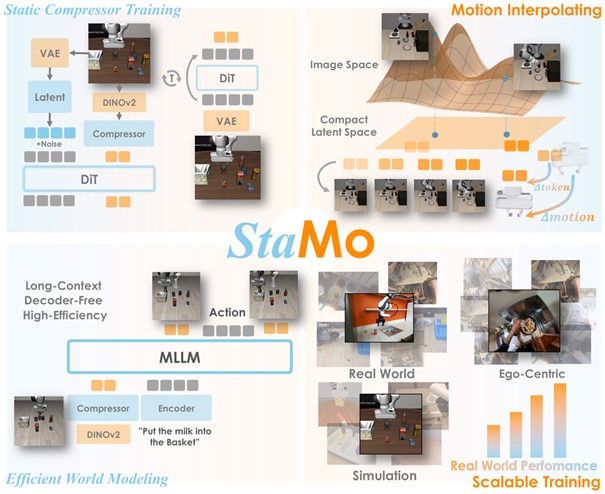
图 1:StaMo 框架总览。轻量编码器(冻结的 DINOv2 + Transformer 压缩器)将单张图像压缩为仅 2 个 token 的紧凑状态表征,预训练扩散解码器(DiT)负责重建图像;运动(latent action)自然地表现为压缩 token 空间中两个状态之差,可进一步解码为可执行动作,并支持高效世界建模与可扩展训练。
从“看视频学动作”到“从静态图像中读出运动”
在视觉-语言-动作(VLA)模型中,用于感知的视觉特征通常信息丰富但高度冗余;而服务于世界建模与中间推理的“状态表征”则需要同时具备两种看似矛盾的性质:一方面要足够紧凑,以贴近动作生成、支持高效的未来预测;另一方面又要足够有表达力,能够编码目标状态、交互动态与结构化的空间关系。轨迹、光流等低维表示虽然紧凑,却往往缺乏语义;而稠密视觉特征虽然丰富,却难以用简单的“做差”来表示运动。与此同时,主流的隐式动作(latent action)学习几乎都依赖视频:用复杂且昂贵的时序模型从连续帧中抽取动作,却常常因为视频片段内部的高方差运动而学到“被平均掉”的、模糊而粗粒度的动作表征。团队由此提出一个更根本的问题——与其费力地从次优的状态表征里建模运动序列,不如反问:能否从单帧图像学到一个足够有表达力的状态表征,使得两个状态之间“简单的差”本身,就恰好编码了一个有意义的隐式动作?
核心思路:把图像压成两个 token,运动“做差”即得
StaMo 用一个在机器人数据上微调的扩散自编码器来回答这一问题:编码器由冻结的 DINOv2 特征提取器与一个 Transformer 压缩器组成,将高维观测压缩为最少仅 2 个、各 1024 维的紧凑 token;解码器则是一个由大规模互联网数据预训练(Stable Diffusion 3)初始化的扩散 Transformer(DiT),以 Flow Matching 目标重建原图。关键直觉在于:要想从如此紧凑的 token 精确重建像素,模型就必须隐式地理解机器人位姿、物体交互等关键状态信息——表达力由此而来。
更重要的发现是:把运动定义为相邻紧凑状态 token 的向量差 a_t = s_{t+1} − s_t,再在潜空间中对起始与目标状态做线性插值,解码出的图像序列竟然天然地连续、合理且动力学一致。这意味着运动作为一种“隐式动作”可以从静态状态空间中自然涌现,无需任何显式的运动监督。该表征能够无缝接入现有 VLM/VLA 框架(如 OpenVLA、OpenVLA-OFT),既可作为世界建模的预测目标(联合预测“下一状态 + 动作”),也能为大量无动作标注的视频生成伪动作标签,用于策略协同训练。
结论与结果:LIBERO +11.6%、真机 +31%,且几乎不增加推理开销
大量仿真与真机实验验证了这一思路的有效性:在 LIBERO 上将基线性能提升 11.6%,真实世界任务成功率提升 31%,而推理速度几乎无损(OpenVLA + StaMo 约 4.0 Hz,与 4.16 Hz 的原始基线相当,远快于 2.27–2.65 Hz 的视频式世界模型方法)。在策略协同训练中,StaMo 生成的伪动作标签优于 LAPA、ATM 等方法达 10.4%;在线性探测(linear probing)中,状态之差在所有预测步长上都取得最低的动作回归误差,表明它是一种高度可线性解码、信息充分的动作表征。模型对未见过的 ManiSkill 环境实现零样本迁移并领先对比方法,且能随仿真、DROID、OXE 乃至人类第一视角视频等更多数据持续扩展。
浙江大学计算机辅助设计与图形系统全国重点实验室沈春华教授、陈昊研究员为本文的通讯作者;博士研究生刘明宇为本文的第一作者。